家のサーバーが勝手に再起動していた ― kdump の記録で原因を探り、起動順を直し、メモリ検査の USB を作る
AWS に置いた監視の画面に、家のサーバーの「異常」が1件だけ残っていました。調べると、家のサーバーは誰も操作していないのに再起動していて、さかのぼると1年余りで14回、カーネルが異常停止していました。ログから原因を探り、新しいカーネルで再起動し、ついでに見つかった「再起動のあと仮想マシンが9分起動しない」問題を直しました。最後に、メモリ検査用の USB メモリを Mac で作る手順をまとめます。
- カーネル:OS の中心部分。ここが止まると、パソコン全体が止まる
- kdump:カーネルが異常停止したとき、その瞬間の記録を残してから再起動する仕組み
- AD(Active Directory):家の中のユーザーやパソコンをまとめて管理する仕組み。これまでの記事:Samba で家に Active Directory を作り、Windows・Mac・NAS を参加させた話
家のサーバーは AlmaLinux 9 で、中で仮想マシンを2台動かしています。AD 用の仮想マシンと、AI 用の仮想マシンです(どちらも Ubuntu 24.04)。AD 用の仮想マシンがこのサーバーの上にあることが、後半の話に関わってきます。
1. きっかけ:監視の画面に「異常」が1件
家のサーバーは1分ごとに、AWS のサーバーの Uptime Kuma へ「生きています」と連絡しています(監視の仕組みは 家のサーバーのセキュリティ対策と監視 に書きました)。その一覧に、次の1行が残っていました。
家のサーバーからの定期連絡 異常 2026-11-06 20:36:02 No heartbeat in the time windowUptime Kuma の記録では、48秒後に正常に戻っていました。今は正常で、過去の出来事が残っていただけです。ただ、連絡が止まった理由は気になります。家のサーバーの起動の記録を見ると、ちょうどその時刻に再起動していました。手で再起動した覚えはありません。
2. 再起動の理由をログで探す
まず、ログインと起動の記録を見ました。
last -x -F | head起動(reboot)の記録はありますが、その前に正常な終了(shutdown)の記録がありません。電源が落ちたか、固まったか、異常停止したかのどれかです。
次に systemd のログ(ジャーナル)を見ようとしましたが、再起動で消える設定だったため、前回の起動の分は残っていませんでした。
決め手は /var/crash でした。kdump が有効になっていて、止まった時刻のフォルダが残っていました。中の vmcore-dmesg.txt に、止まる瞬間のカーネルのメッセージが入っています。
sudo ls /var/crash
sudo grep -a -E 'BUG:|Oops|RIP:|Comm:' /var/crash/127.0.0.1-2026-11-06-20:35:02/vmcore-dmesg.txt
php-fpm(WordPress などを動かす部分)の処理中に、カーネルが「扱えないメモリの場所を指した」(BUG: unable to handle page fault)という理由で止まっていました。
3. 異常停止は14回あった
/var/crash には、同じような記録がほかにもたくさんありました。今回の分を含めて14回です。
| 日時 | 動いていたプログラム | 止まった場所(カーネルの関数) |
|---|---|---|
| 2025-09-18 | umount | bpf_local_storage_destroy |
| 2025-09-19 | umount | bpf_local_storage_destroy |
| 2025-09-28 | clamd | vfs_getattr_nosec |
| 2025-10-11 | dnf-automatic | radix_tree_insert |
| 2026-02-10 | clamd | do_dentry_open |
| 2026-03-02 | clamd | xlog_prepare_iovec(xfs) |
| 2026-05-09 | cleanup | list_lru_del |
| 2026-08-16 | kworker | css_free_rwork_fn |
| 2026-08-16 | named | kmem_cache_alloc |
| 2026-08-19 | named | kmem_cache_alloc |
| 2026-09-10 | clamd | filemap_get_read_batch |
| 2026-11-06 | php-fpm | xlog_prepare_iovec(xfs) |
| 2026-11-07 | php-fpm | メモリの管理表の破損(Bad page map) |
| 2026-11-08 | (待機中) | napi_gro_flush(double fault) |
カーネルの版は、この間に何度も新しくなっています。それでも止まり続けていて、止まった場所も、動いていたプログラムもばらばらです。特定のソフトの不具合なら、同じ場所で止まることが多いはずです。そのため、メモリなどのハードウェアの不安定さを疑いました。
ほかに確かめたことです。
- メモリは DDR4-3200 の 16GB×2 枚。
sudo dmidecode -t 17で見ると、標準の速さと電圧(1.2V)で動いていた。高速化の設定(XMP)は使っていない - メモリはエラーを見つけて直す機能(ECC)が無い。そのため、メモリのビットが化けても記録には残らず、いきなり止まる形でしか表に出ない
- CPU が自分で知らせるハードウェアのエラー(MCE)の記録も無かった
4. 新しいカーネルで再起動 → また止まった
自動更新で新しいカーネルが入っていたので、念のため再起動して切り替えました。自動更新(dnf-automatic)は再起動しない設定なので、新しいカーネルは再起動するまで使われません。再起動の前に、仮想マシンを正常に終了させておきます。
sudo virsh shutdown vm1
sudo virsh shutdown vm-ad
sudo virsh list --all      # 2台とも「シャットオフ」になったのを確認
sudo grubby --default-kernel   # 次に起動するカーネルを確認
sudo systemctl rebootところが、この後の30分でさらに2回止まりました。
- 再起動の終了処理の途中:メモリの管理表(ページ表)の中身が壊れている、というエラー。壊れた値は
100000000で、1ビットだけが立った形。メモリのビット化けでよく見る形です - 新しいカーネルで起動して9分後:
double fault(エラーの処理中にさらにエラーが起きた状態)。止まった瞬間の作業場所を指す値が、上半分だけ消えた形で壊れていた。同じ場所を指す別の値は正常なままでした
新しいカーネルでも止まったので、カーネルの問題ではないことがよりはっきりしました。ソフトの処理では普通は起きない値の壊れ方で、メモリ・CPU・電源のどれかが不安定だと考えています。ログだけでは、どの部品かまでは決められません。
5. おまけの問題:再起動のあと、仮想マシンが9分起動しない
新しいカーネルで再起動したとき、家のサーバー自体は1分ほどで起動しました。ところが、仮想マシンは2台とも9分起動せず、sudo も返事をしなくなりました。ログには次のような行が並んでいました。
winbindd: cm_connect_lsat: Unable to connect to DC (null) of domain XXXX over TCP/IP: NT_STATUS_DOMAIN_CONTROLLER_NOT_FOUND.
winbindd: winbind_client_processed: request took 62.711957 seconds
winbind は、Linux から AD のユーザーやグループを調べる役のソフトです。家のサーバーは、ユーザーとグループを調べるとき、自分の一覧に加えて winbind にも問い合わせる設定です(/etc/nsswitch.conf の passwd・group に winbind がある)。
起動直後は、AD 用の仮想マシンがまだ動いていません。winbind は AD を探して待ち続け、問い合わせ1件に約60秒かかっていました。sudo も、仮想マシンを動かすソフト(virtqemud)も、ユーザーのグループを調べる途中でこの待ちに巻き込まれたとみられます。仮想マシンが起動しないので AD も動かない、という「ニワトリと卵」の状態です。前回の異常停止のときも、AD 用の仮想マシンは12分遅れて起動していました。
そこで、起動の順番を入れ替えました。仮想マシンを先に起動し、AD が応答してから winbind を起動します。winbind が動いていない間は、問い合わせはすぐに「見つからない」で返るので、待たされません。
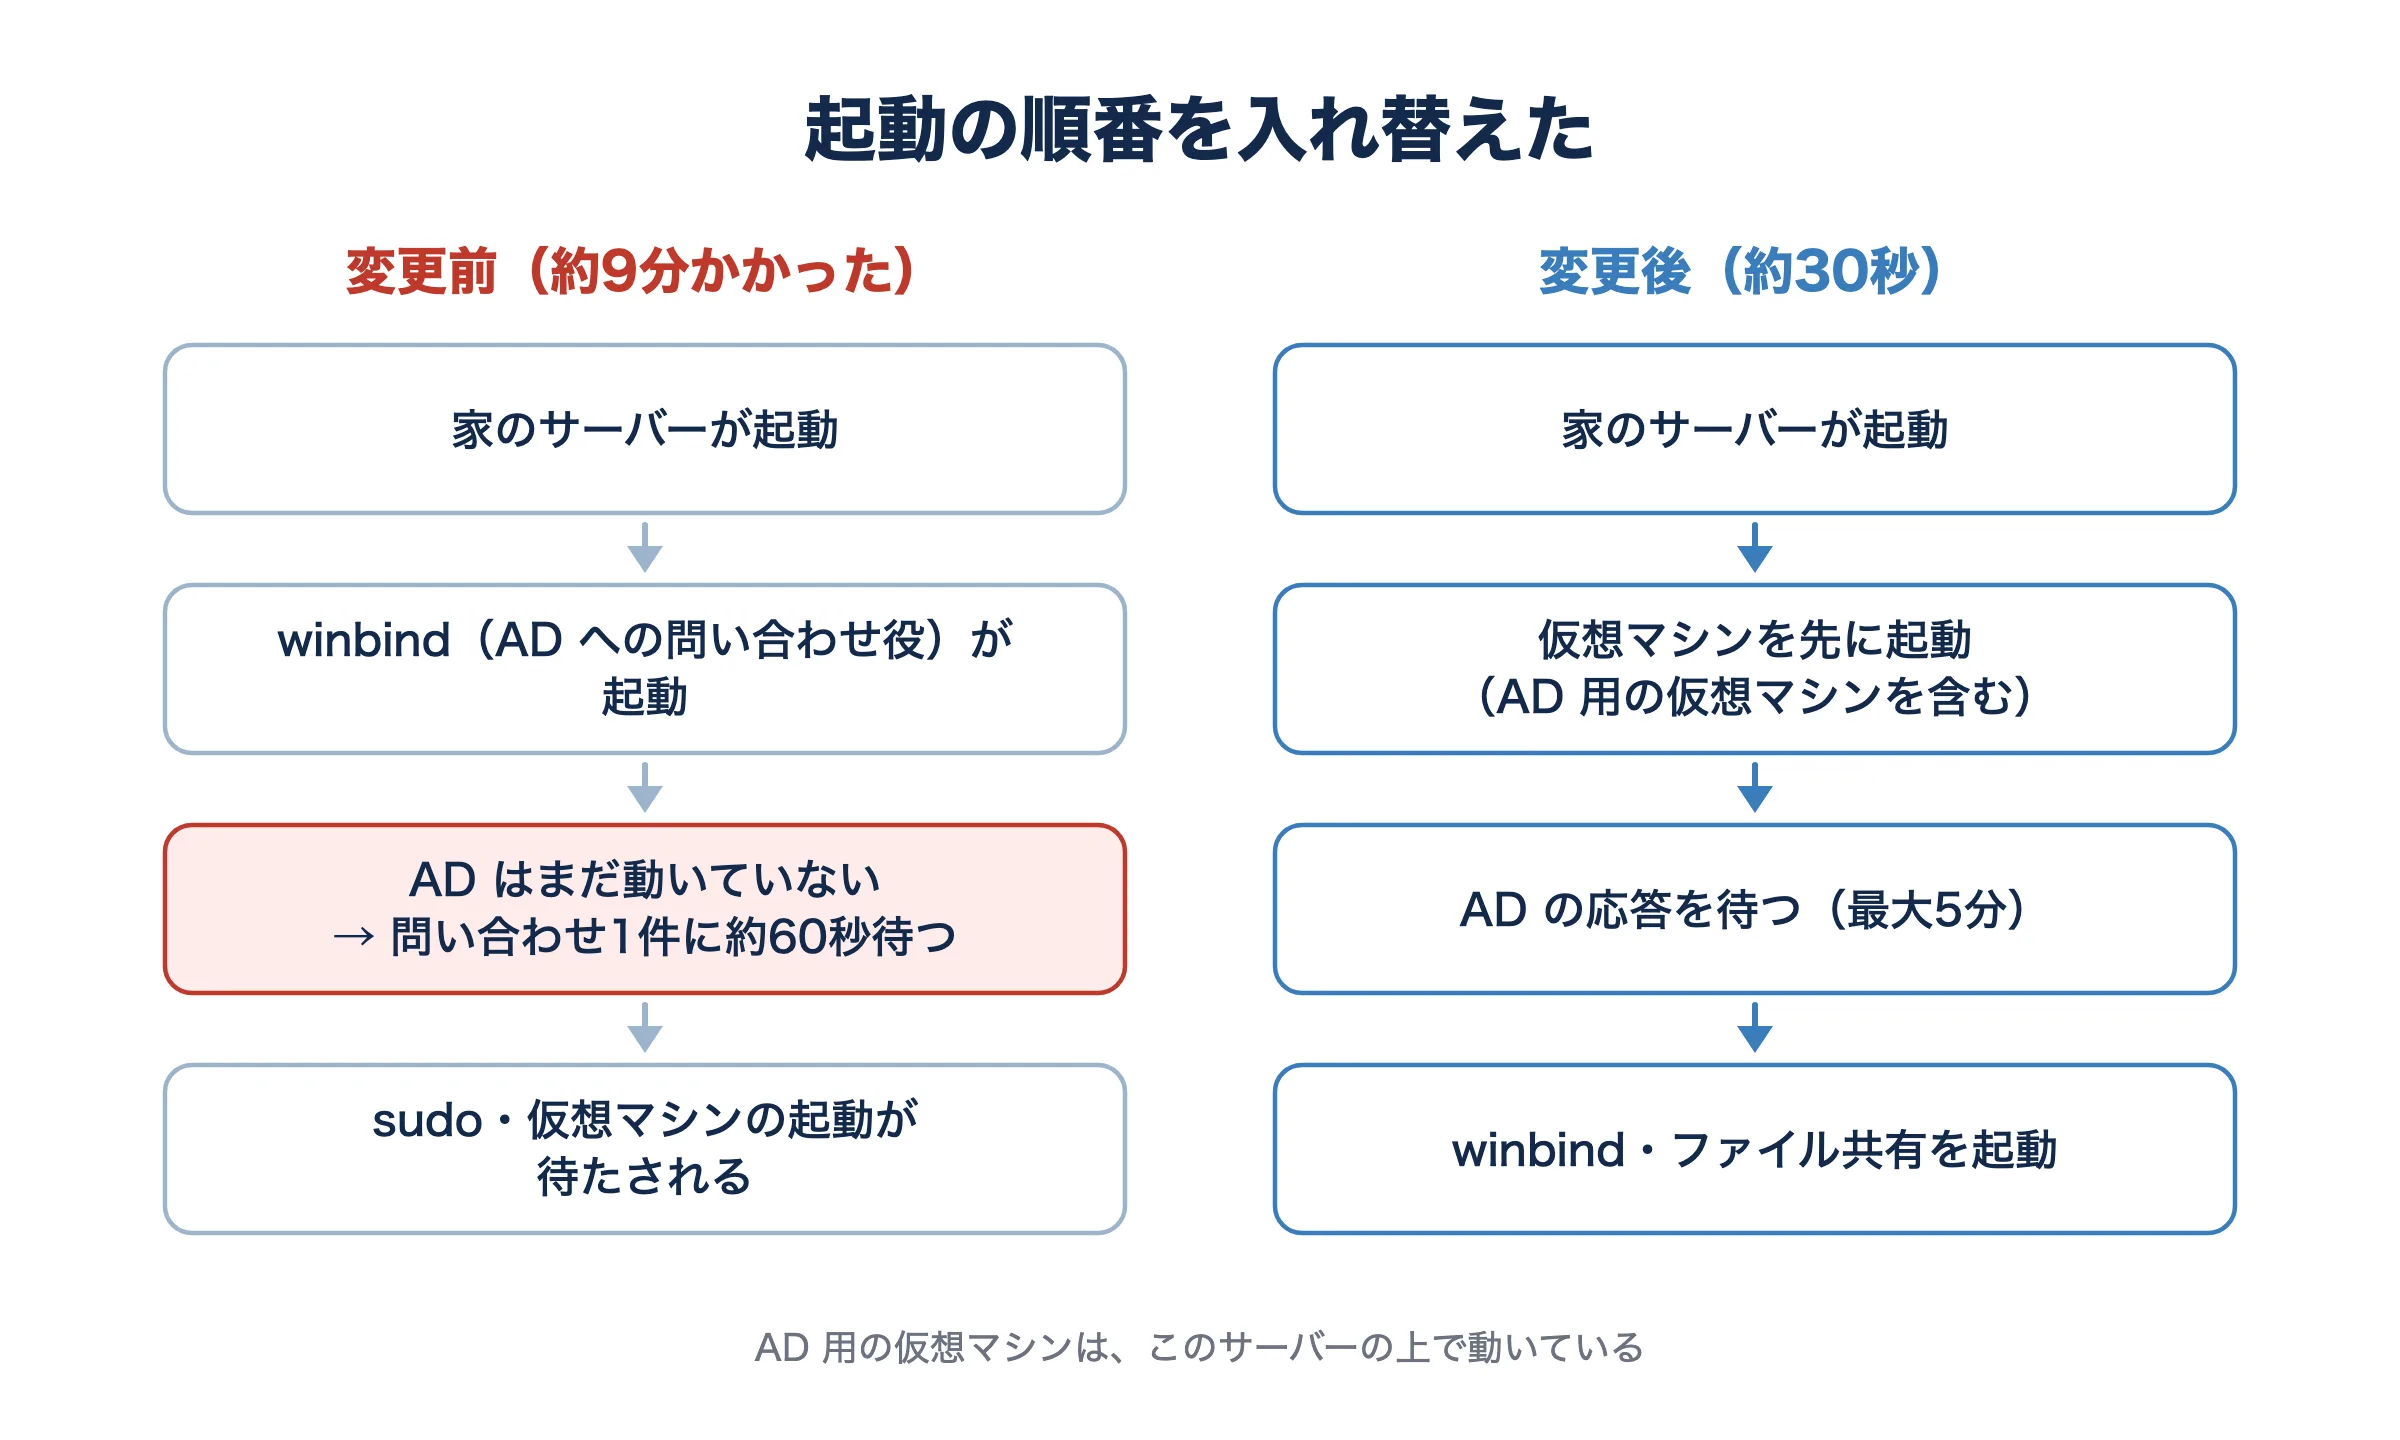
入れた設定は3つです(ファイル名は記事用に変えています)。まず、AD の応答(LDAP の 389 番)を5秒ごと・最大5分待つスクリプトです。5分たっても応答が無ければ、待つのをやめて先に進みます。AD が壊れていても、サーバーの起動は止まりません。
# /usr/local/sbin/wait-for-ad.sh
#!/bin/sh
for i in $(seq 1 60); do
  if nc -z -w 2 192.168.x.x 389; then
    echo "AD 応答あり(${i}回目)"
    exit 0
  fi
  sleep 5
done
echo "AD が5分以内に応答しなかったため、待たずに winbind を起動する"
exit 0
このスクリプトを、仮想マシンを動かすソフトの起動後に1回だけ動かすサービスにします。
# /etc/systemd/system/wait-for-ad.service
[Unit]
Description=Wait for AD (VM on this host) before starting winbind
Wants=network-online.target
After=network-online.target virtqemud.service

[Service]
Type=oneshot
RemainAfterExit=yes
ExecStart=/usr/local/sbin/wait-for-ad.sh
TimeoutStartSec=360

[Install]
WantedBy=multi-user.target
最後に、winbind をこのサービスの後に起動させます。winbind.service そのものは書き換えず、追加の設定ファイル(ドロップイン)で足します。ファイル共有(smb)は元から winbind の後に起動する設定なので、一緒に後回しになります。
# /etc/systemd/system/winbind.service.d/10-wait-for-ad.conf
[Unit]
Wants=wait-for-ad.service
After=wait-for-ad.service
sudo chmod 755 /usr/local/sbin/wait-for-ad.sh
sudo restorecon -R /usr/local/sbin/wait-for-ad.sh /etc/systemd/system/wait-for-ad.service /etc/systemd/system/winbind.service.d
sudo systemctl daemon-reload
sudo systemctl enable wait-for-ad.serviceもう一度再起動して確かめました。
| 時刻 | 出来事 |
|---|---|
| 00:00:40 | 家のサーバーが起動 |
| 00:01:02 | AD の応答を確認(3回目)→ winbind・ファイル共有が起動 |
| 00:01:11 | 仮想マシン2台に接続できるように |
9分かかっていた起動が、約30秒になりました。sudo の遅れも、winbind の長い待ちの記録もなくなりました。元に戻すときは、サービスを無効にして3つのファイルを消し、systemctl daemon-reload を実行します。
ついでに、AI 用の仮想マシンで毎回出ていた lightdm(画面にログイン画面を出す仕組み)の失敗も止めました。この仮想マシンには画面の装置が無く、毎回「no screens found」で失敗していました。普段は TigerVNC の仮想の画面を使っていて lightdm とは関係ないので、sudo systemctl disable lightdm で自動起動を止めました。
6. メモリ検査用の USB メモリを Mac で作る
メモリの検査には memtest86+ を使います。パソコンを USB メモリから起動して、OS を使わずにメモリを読み書きして調べるソフトです。
AlmaLinux にも memtest86+ のパッケージはありますが、版が古く(5.31)、このサーバーの起動方式(UEFI)では動きません。そこで、公式サイトの最新版(記事を書いた時点で v9.00)を USB メモリに入れます。
- memtest.org の Download から、Linux ISO(64-bit)(
mt86plus_9.00_x86_64.iso.zip)をダウンロードし、zip を展開する。Windows 用の USB インストーラーは Mac では使えない - balenaEtcher を入れる。公式サイトによると、Mac のディスクユーティリティの「復元」では起動できる USB にならない。ISO のファイルを USB メモリにコピーするだけでもだめ
- balenaEtcher で「Flash from file」に展開した ISO、「Select target」に USB メモリを選び、「Flash!」を押す。USB メモリの中身はすべて消えるので、選ぶ先を間違えないようにする
- 書き込みが終わると、Mac が「読み込めないディスク」と表示することがある。その場合は「取り出す」を選んで抜けばよい
v9.00 は署名付きですが、Microsoft の署名ではないので、セキュアブートが有効だと起動を止められることがあります。このサーバーはセキュアブートが無効だったので(mokutil --sb-state で確認)、そのまま使えます。
7. 検査の手順
- 監視(Uptime Kuma など)で、家のサーバーに関係する監視を一時停止する。止めないと通知メールが続けて届く
- 検査の間は AD も止まるので、家の Windows のドメインへのログインなどに影響が出る。使う人に伝えておく
- 仮想マシンを正常に終了させてから、サーバーの電源を切る(
sudo virsh shutdown→sudo shutdown -h now) - サーバーに画面とキーボードをつなぎ、USB メモリを差して電源を入れる。起動中に起動メニューのキー(ASUS のマザーボードでは F8 が多い。F12・ESC の機種もある)を押し、USB メモリを選ぶ
- 検査が自動で始まる。最低4周(Pass 4)か、ひと晩流す。エラーが1つでも出たら不良
- エラーが出たら、メモリを1枚ずつ差して検査し直し、どちらが不良かを確かめる
- 終わったら USB メモリを抜いて起動し、仮想マシンと監視が戻ったかを確認する
メモリにエラーが出なかった場合は、BIOS の更新、BIOS の電源まわりの設定、電源ユニットの順に疑う予定です。検査の結果は、この記事に追記します。
まとめ
- 監視の「異常」1件から、家のサーバーの気づかなかった異常停止が見つかった。
/var/crashに kdump の記録が14回分残っていた - 止まる場所・プログラム・カーネルの版がばらばらで、新しいカーネルでも止まった。ハードウェアを疑う
- ECC の無いメモリでは、ビット化けは記録に残らず、異常停止としてしか表に出ない
- AD の仮想マシンを同じサーバーに置くと、起動時に winbind が AD を待って全体が止まる。winbind を AD の応答の後に起動するようにして、9分 → 約30秒になった
- memtest86+ の USB メモリは、Mac なら balenaEtcher で ISO を書き込んで作る