AI 用の仮想マシンが2日続けて固まった ― ログからメモリの不安定さを疑い、2666MHz に下げて見張る
 ojiji
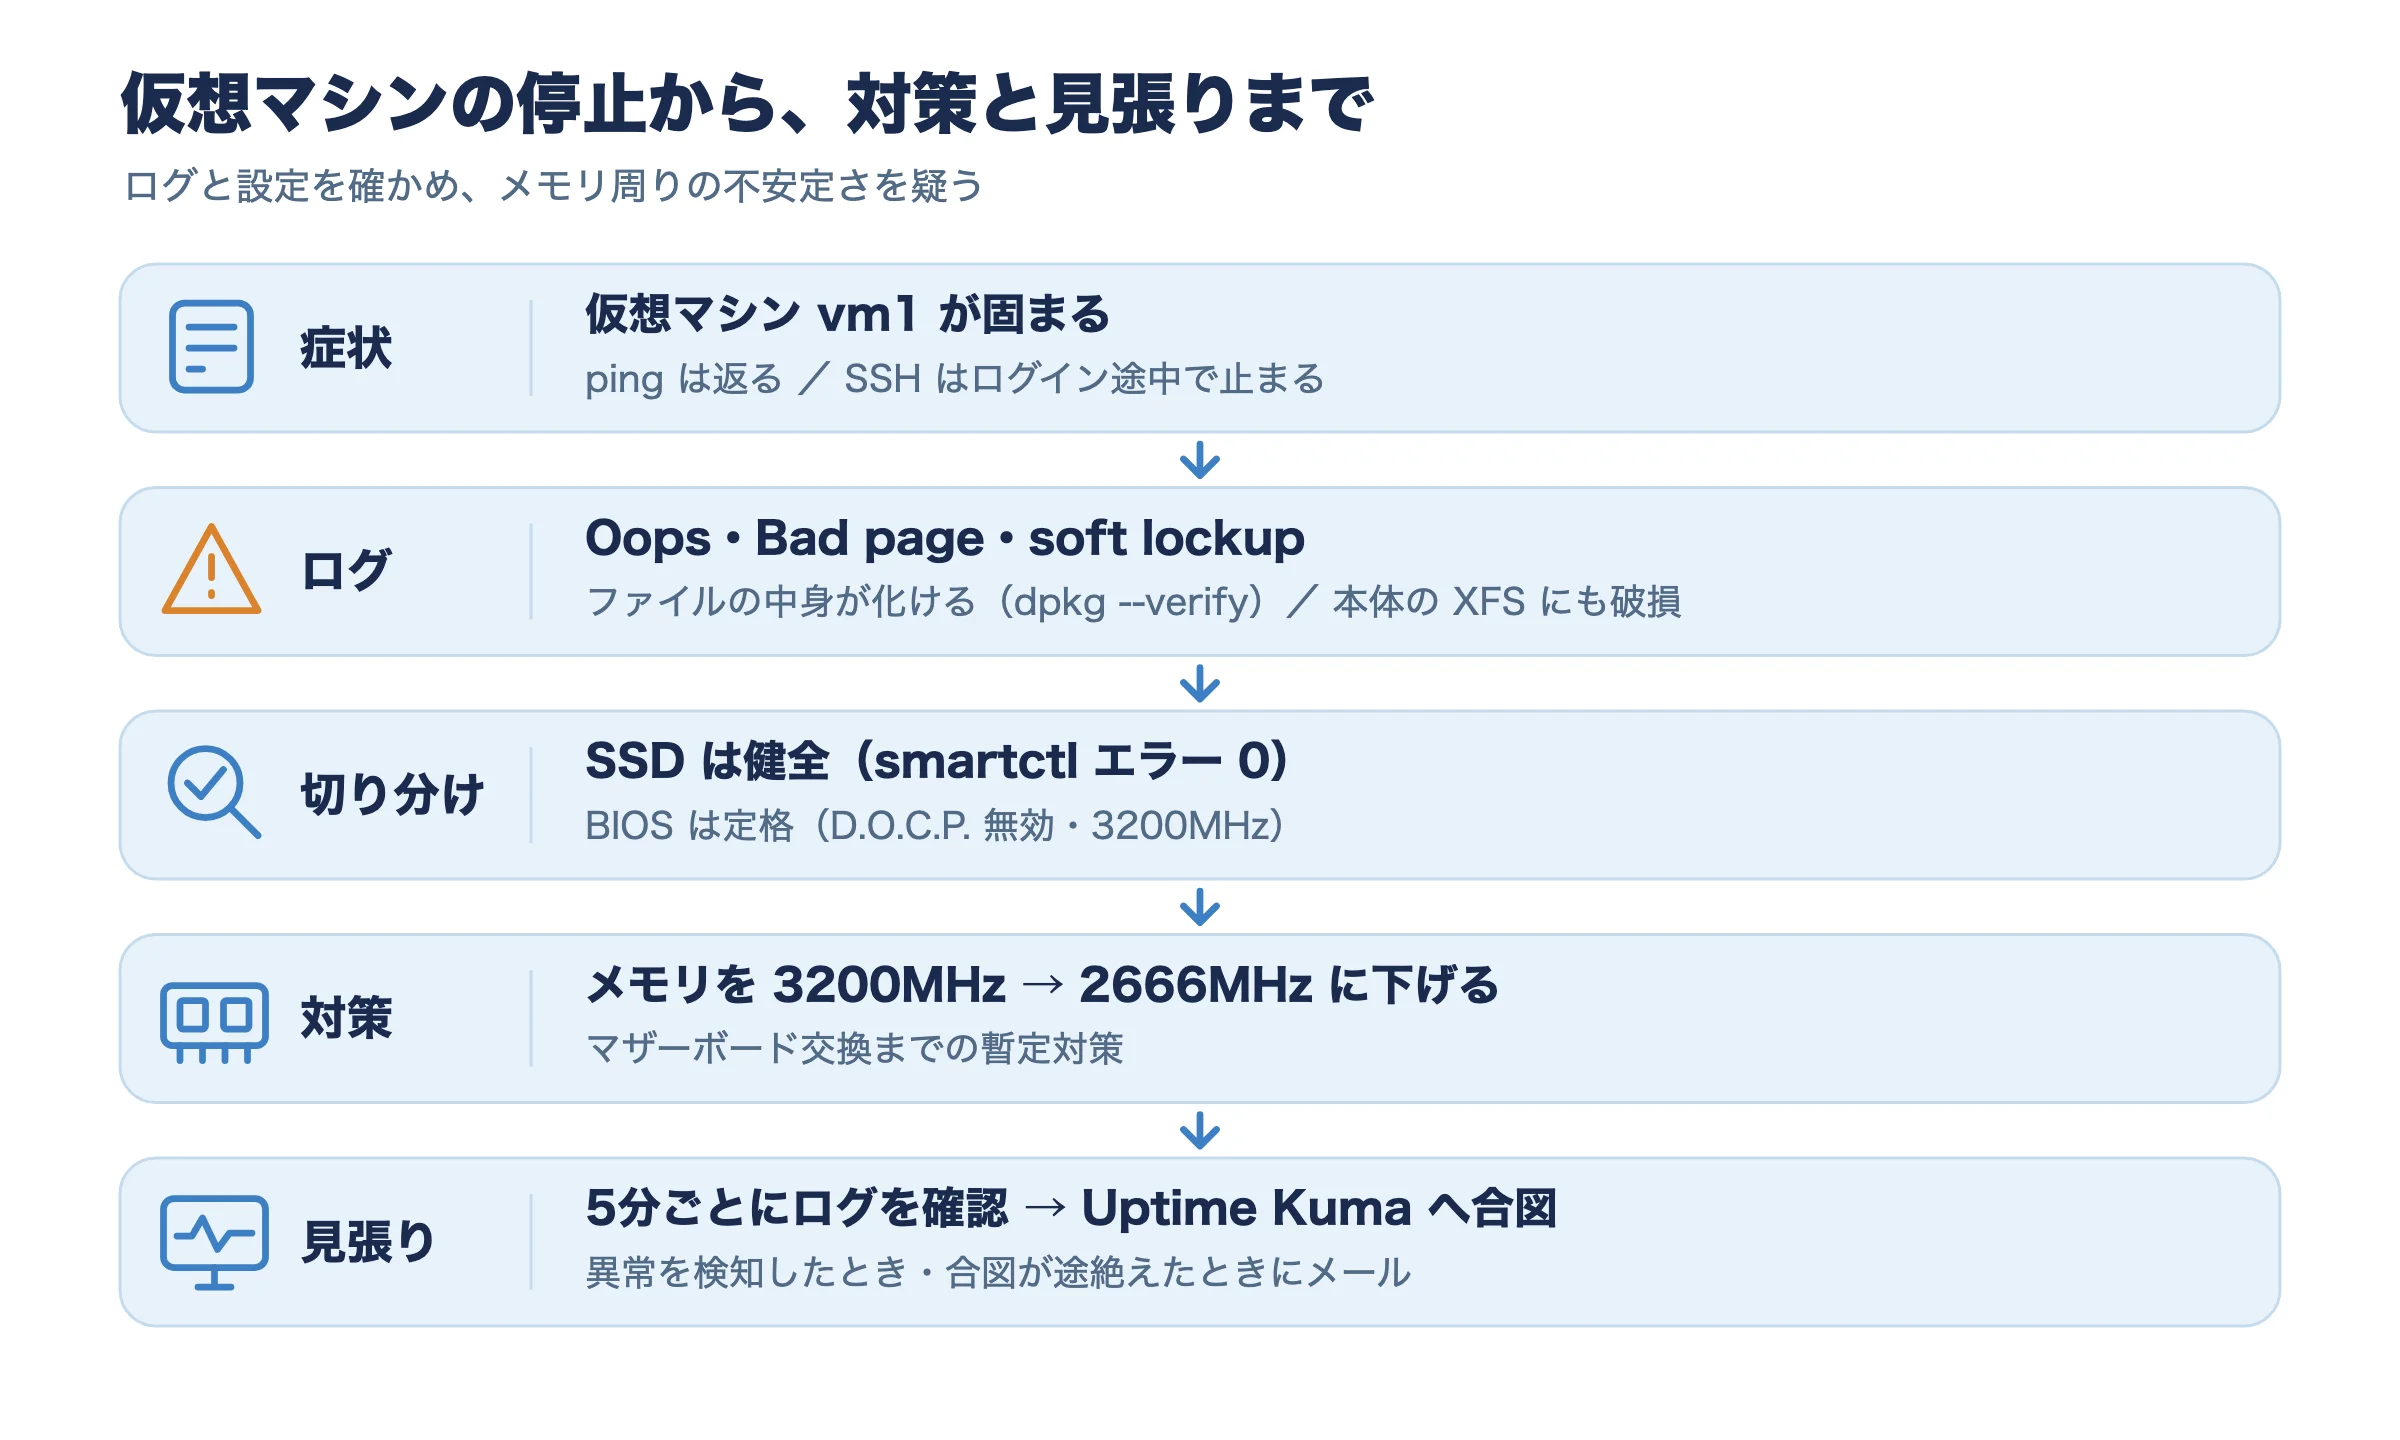
家のサーバーの中で動かしている AI 用の仮想マシン(ここでは vm1)が、深夜と夕方の2回、続けて固まりました。ログを追うと、仮想マシンの中でメモリの中身が壊れた形跡があり、家のサーバー本体のファイルシステムにも破損の記録が出ていました。SSD は健全で、BIOS もオーバークロックなしの定格だったので、メモリ周り(マザーボードか、CPU の中のメモリを制御する部分)を疑っています。マザーボードの交換を待つ間、メモリの速さを 3200MHz から 2666MHz に下げ、固まったらメールが届く見張りを付けて様子を見ることにしました。
- soft lockup:CPU の1つが長い時間、同じ処理から抜け出せなくなった状態。Linux のカーネルが見つけて記録する
- Oops:カーネルの中で起きた、本来ありえない異常の記録
- dpkg --verify:Ubuntu で、入れたパッケージのファイルが元の中身のままかを確かめるコマンド
- XFS・ext4:ファイルシステムの種類。家のサーバー本体(AlmaLinux)は XFS、仮想マシン(Ubuntu)は ext4
1. 症状:ping は返るのに、ログインの途中で止まる
気づいたのは、vm1 で動かしている AI のチャットが返事をしなくなったことでした。外から確かめると、次のような中途半端な状態です。
- ping には返事がある
- SSH はつながるが、鍵の確認の直後で止まり、90秒待ってもログインできない
- 家のサーバーから見ると、仮想マシンは CPU を使い続けている
OS の通信の部分だけが生きていて、プログラムを動かす部分が止まっている状態です。中に入れないので、家のサーバー側から仮想マシンを強制的にリセットしました。
sudo virsh reset vm12. 1回目(深夜):カーネルの中でメモリが壊れていた
起動し直してから、前回の起動のログを読みました。
sudo journalctl -b -1 -k | grep -iE "oops|bad page|invalid opcode|soft lockup"- 19時ごろ:メモリを整理するカーネルの処理(
kswapd0)が、壊れたアドレスを読んで Oops - その後:
sshdがinvalid opcode(ありえない命令)で落ち、Bad page map(メモリの対応表の破損)も記録 - 23時ごろから:AI の Bot の処理で CPU が soft lockup になり、約2時間後には全体が固まった
プログラムの不具合というより、メモリの中身そのものが化けているときの症状です。さらに、強制リセットの後は ext4 の管理情報の破損も見つかりました。仮想マシンを止め、ディスクの写しを取ってから e2fsck で修復しています。
3. 2回目(夕方):Bot が落ちた直後に固まり、ファイルの中身も化けた
修復から約13時間後、また同じ症状で固まりました。今回のログは次のとおりです。
- 14:39:07:Discord の Bot(OpenClaw)が
SEGV(不正なメモリの参照)で落ち、自動で起動し直す - 14:39:49 から:起動し直した Bot の処理で、CPU が soft lockup。カーネルの中のロック(同時に触らないための鍵)が外れないまま、約2時間
起動し直した後に dpkg --verify をかけると、3つのファイルの中身が元と違っていました。前の晩の修復の直後は 0 件だったので、その後に化けたことになります。ファイルの更新日時は古いままで、書き換えた覚えのないファイルです。
$ sudo dpkg --verify | grep -v " c /etc"
??5??????   /opt/google/chrome/chrome
??5??????   /usr/lib/python3.12/xmlrpc/server.py
??5??????   /usr/lib/x86_64-linux-gnu/perl/5.38.2/auto/Encode/TW/TW.so
5 は「中身のチェックサムが違う」という印です。パッケージを入れ直して元に戻しました。
sudo apt-get install --reinstall libpython3.12-stdlib libperl5.38t64 google-chrome-stable
sudo dpkg --verify | grep -v " c /etc"    # 何も出なければ OK
4. 家のサーバー本体にも破損の記録があった
仮想マシンの中だけの問題かを確かめるため、家のサーバー本体のログも見ました。すると、システムの区画(XFS)で、同じ場所の管理情報の破損が何度も記録されていました。最初の記録は、少し前にメモリを交換した日の夜です。
XFS (dm-0): Metadata corruption detected at xfs_dinode_verify ... inode 0xdcf59
XFS (dm-0): Unmount and run xfs_repair
ディスクが原因かもしれないので、SSD の健康状態を smartctl で確かめました。
$ sudo smartctl -a /dev/nvme0n1 | grep -iE "critical|media|error|percentage|spare"
Critical Warning:                   0x00
Available Spare:                    100%
Percentage Used:                    1%
Media and Data Integrity Errors:    0
No Errors Logged
警告もエラーもなく、寿命も 1% しか使っていません。SSD は健全です。ディスクではなく、メモリに置いた段階で中身が化けていると考えるほうが、仮想マシンの症状とも合います。
5. BIOS を確かめ、メモリを 2666MHz に下げた
メモリが不安定になる原因でよくあるのが、メモリを定格より速く動かす設定です(ASUS の AMD 用マザーボードでは D.O.C.P.、ほかでは XMP・EXPO)。家のサーバー(ASUS の A520 のマザーボード)を止めて、BIOS の Ai Tweaker の画面を確かめました。
- Ai Overclock Tuner:
Auto(D.O.C.P. は無効) - メモリ:3200MHz、1.200V(DDR4 の定格どおり)
- CPU・SOC などの電圧:すべて
Auto
オーバークロックはしていませんでした。設定が原因ではないので、残る候補はマザーボードか、CPU の中のメモリコントローラーです(AMD の CPU は、メモリを制御する部分が CPU の中にあります)。交換用のマザーボードが届くまでの間は、Memory Frequency を DDR4-2666MHz に下げて、余裕を持たせることにしました。サーバーの使い方なら、体感の差はほとんどありません。
$ sudo dmidecode -t memory | grep "Configured Memory Speed"
        Configured Memory Speed: 2666 MT/s
        Configured Memory Speed: 2666 MT/s
なお、2回とも Bot(OpenClaw)の処理の中で固まっていました。止めておけば再発しにくくなりそうですが、それでは「速さを下げたから直ったのか、Bot を止めたから直ったのか」が分かりません。原因を切り分けるため、Bot は動かしたままにしています。
6. 再発したらメールが届く見張りを付けた
様子を見るには、再発にすぐ気づけることが大事です。vm1 の中に、次の2つを見張るスクリプトを置き、systemd のタイマーで動かしています。
- 5分ごと:前回からのログに soft lockup・Oops・Bad page・invalid opcode・ext4 のエラー・Bot の異常終了が出ていないか
- 毎日1回:
dpkg --verifyで、ファイルの中身が化けていないか
# 前回読んだ位置(cursor)から先だけを調べる
hits=$(journalctl --cursor-file="$STATE/cursor" -q --no-pager -o short-iso \
  | grep -E "soft lockup|hard LOCKUP|Oops|BUG:|Bad page|invalid opcode|general protection|EXT4-fs error|Memory failure|code=dumped")
if [ -n "$hits" ]; then
  echo "$(date '+%F %T') $(echo "$hits" | head -1)" >> "$ALERT"   # 消すまで「異常あり」のまま
fi

# 監視サーバーへ、異常がなければ up、あれば down を送る
if [ -s "$ALERT" ]; then
  curl -fsS -m 15 "${PUSH_URL}?status=down&msg=..."
else
  curl -fsS -m 15 "${PUSH_URL}?status=up&msg=OK"
fi
送り先は、AWS で動かしている Uptime Kuma の Push 型の見張り(間隔 10分)です。この形にすると、次の2つのどちらでもメールが届きます。
- 異常を見つけたとき:スクリプトが down を送る
- vm1 そのものが固まったとき:up の合図が来なくなるので、Uptime Kuma が「停止」と判定する
固まった仮想マシンは自分で「固まった」と知らせられないので、合図が途絶えたことを外から見るのがポイントです。仕組みが正しく動くかは、カーネルのログにテストの文字を書き込んで確かめました。
echo "<4>health TEST soft lockup (test message)" | sudo tee /dev/kmsg7. 同じサーバーの AD の仮想マシンは無事だった
同じ家のサーバーでは、AD(Samba)の仮想マシンも動いています。こちらも確かめましたが、異常はありませんでした。
- 今月に入ってからのカーネルのログに、固まり・メモリの破損・ext4 のエラーは 0 件
dpkg --verifyの不一致は 0 件- AD のデータベースの点検(
samba-tool dbcheck)もエラー 0 件
AD の仮想マシンは負荷が軽く、メモリもあまり使いません。一方、AI 用の vm1 は AI のツールやブラウザーでメモリも CPU もたくさん使うので、不安定な部分に当たりやすいのだと考えています(推測です)。
8. まとめと、これから
- 症状:ping は返るのにログインできない固まりが、仮想マシンで2回
- ログ:Oops・Bad page・soft lockup と、ファイルの中身の化け。家のサーバー本体でも XFS の破損
- SSD は健全、BIOS は定格 → メモリ周り(マザーボード・CPU のメモリ制御)を疑う
- 当面の対策:メモリを 2666MHz に下げ、再発したらメールが届く見張りを付けて様子見
マザーボードが届いたら交換し、メモリの速さを Auto に戻します。あわせて、家のサーバー本体の XFS を xfs_repair で直す予定です(システムの区画なので、レスキュー用の起動で行います)。2666MHz で再発しなければ、メモリ周りの余裕の足りなさが原因だった、という手がかりになります。結果が出たら、続きを書きます。